JavaScript のソースコードを (意地でも) 小さくする技術
JavaScript のソースコードを小さくする方法として UglifyJS や Terser といった minification ツールを用いるものが良く知られています。 これらはソースコード中の空白やコメントを削除し、変数名などを短い形式にすることで、ソースコードを小さくしています。
こういった minification ツールを適用し、さらに GZip などで圧縮して配信するのが今日の Web での標準的な方法となっています。 ですが、JavaScript を圧縮できる可能性のある方法として、自己解凍的な圧縮技術を用いる、というアイディアがあります。
この記事では、そういった自己解凍的な圧縮技術として JS Crush や Roadroller について紹介します。
はじめに
この辺りは与太話なので飛ばしていただいても構いません。
h.js という JavaScript のシンタックスハイライティングライブラリをご存知でしょうか? 1.5KB 程度という軽量のライブラリで、比較的高速に JavaScript のシンタックスハイライトが行えます。 また、最新の構文にもそこそこちゃんと対応しています。
そして、このライブラリの最大の特徴は、そのソースコードの形状です。 このライブラリのソースコードは ASCII アートになっていて、h.js という文字を表しているのが分かると思います。
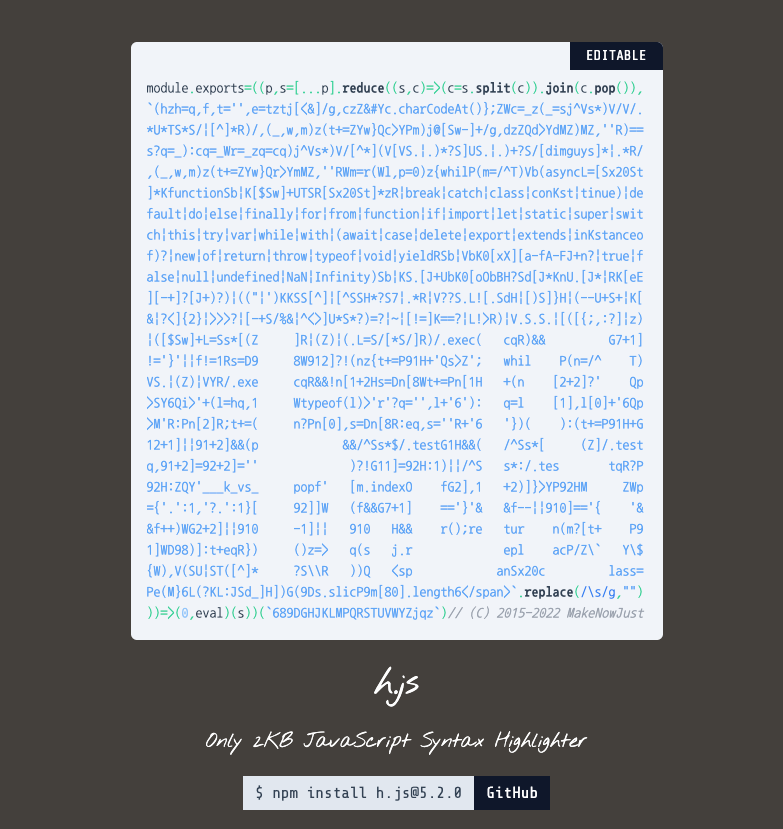
ソースコードの形状自体はテンプレートリテラルを使っているだけなので大したものではないのですが、実はこのソースコードは圧縮されています。
実際、最後の方の eval を console.log に置き換えると 1900 文字程度のソースコードが出現するはずです。
さて、このソースコードをよく見ていると、シンタックスハイライトの実装が細切れのようになっているのが分かると思います。 一体どのようにして圧縮を、そしてソースコードの中で解凍を実現しているのでしょうか?
JS Crush
JavaScript を圧縮するツールとしては老舗で、Aivo Pass 氏が公開しているものです。 1KB 以下の JavaScript のプログラムのコンテスト JS1K でもよく使われていて、 なんとこの JS Crush 自体を 1KB で実装したもの も 2012 年のコンテストで 5 位を受賞しています。
Grammar-Based Code
JS Crush の背景にある圧縮のアイディアは非常に単純で「出現頻度の高い部分文字列を別の記号で置き換えることで、元の文字列よりも短い表現を得る」というものになります。
例として abcdefabcef という文字列を圧縮することを考えましょう。
この文字列の中で、出現頻度が高くて長さもある部分文字列は abc なので、これを A で置き換えます。
すると文字列は AdefAef と A=abc となります。
次に、文字列中の ef を B で置き換えると、さらに縮みそうです。
これを適用すると、文字列は AdBAB と A=abc, B=ef となります。
さらに、より縮められそうな部分がもうないので、これが圧縮された表現となります。
よく出現する部分文字列を 1 文字の記号に置き換えれば文字列が短くなる、というのはシンプルで分かりやすいアイディアなのではないかと思います。 そして、このような圧縮方法と表現を Grammar-Based Code と呼びます。
ただし、部分文字列の置き換えは再帰的に行われる可能性がある、ということに注意してください。
例えば abcabdabcabd という文字列は AA と A=BcBd, B=ab という表現に圧縮されます。
解凍方法
解凍はとても簡単です。 置き換えた記号と対応する文字列の組 (文法) が与えられれば、それらを圧縮された文字列に対して置き換えていくことで、元の文字列が得られます。
しかし、実装する上では「どのように文法を表現するか」と「解凍をどのように小さく実装するか」が問題となります。 圧縮された文字列が小さくても、文法が大きくなってしまったり、解凍のためのコードの量が増えてしまっては仕方がありません。
そこで、文法を圧縮された文字列の末尾に追加していくことを考えます。
先程の例の場合は AdBAB と A=abc, B=ef なので AdBABAabcBef のようになります。
ここで、B を置き換えたい場合 B に対応する文字列は split('B') として作った配列を pop すれば得られます。
さらに、配列の残りの要素をその文字列で join すれば、置き換えまで完了します。
具体的には c = "AdBABAabcBef".split('B') = ["Adb", "A", "Aabc", "ef"] で c.pop() === "ef" なので、 c.join(c.pop()) === "AdefAef" となり、B の置き換えを行なったあとの文字列になっています。
あとは置き換える記号を別で持っておいて、それを順番に適用すればいいことになります。 よって、最終的なコードは次のような形になります。 JS Crush が出力するコードや h.js のソースコードも、よく見るとこのような形になっていることが分かると思います。
r = "圧縮された文字列";
p = "置き換える記号列";
eval([...p].reduce((s, c) => (c = s.splic(c)).join(c.pop()), s));
展開の部分がとても短いのが分かるでしょう。 空白を除くと 52B しかないので、それよりも圧縮で縮むのであれば、ソースコードを小さくできるわけです。
圧縮方法
圧縮に関してはそれほど面白い部分はありません。
JS Crush では、文字列中の全ての部分文字列について出現回数を調べて、圧縮することで何バイト程度減るかを計算し、それが最も大きくなるものを選ぶ、というのを圧縮できるものか、ソースコード中に含まれない文字が無くなるまで繰り返しています。
これはかなり非効率的なアルゴリズムなのですが、数千バイト程度の入力であればどうにか動作します。 入力がより大きくなった場合には、もしかしたら時間がかかりすぎるかもしれません。
Roadroller
比較的最近の JavaScript の圧縮ツールとして Roadroller というものも知られています。
これは圧縮方法に rANS とコンテキストミキシングを使ったもので、解凍部分のコードはやや大きいものの、 JS Crush よりも高い圧縮率を誇るため、多くの場合より小さなソースコードが得られます。
rANS
rANS は Range variant Asymmetric Numeral System の略で、Jarosław Duda が 2014 年に発表した Asymmetric Numeral System (ANS) の一種です。 ANS 自体は Facebook の Zstandard などで使われている圧縮手法でもあります。
ANS の核となるアイディアは、そこまで難しくありません。
次のようなコインを使った遊びを考えます。
       表: k=[ 0] : n
d=[ 1]
       裏: l=[ 0] : m
コインを振って、表が出た場合は表のカウンターを 1 増やす、裏が出た場合は裏のカウンターを 1 増やします。 さらに、裏表のカウンターがその右の数字 (表なら 、裏なら ) 以上になったときに、左のカウンターを 1 増やして、そのカウンターは 0 に戻します。
最終的な得点を とします。 コインの裏表の出る確率が分かっていて、 と をプレイヤーが設定できるとして、この得点をなるべく小さくするにはどうすればいいでしょうか?
もしコインの裏表が出る確率が同様に確からしいのであれば、 にするのがよいはずです。 一方、表が で裏が で出るような偏ったコインであれば、 として、 表が出たときに左のカウンタが進むのを遅らせたほうがいいというのも分かると思います。
ここでコインの裏表をビット列の 0 と 1 に置き替えると、この と の割り当てが圧縮方法となっていることがイメージできないでしょうか? 通常のバイナリ表現では 1 つの桁で 0 と 1 を 1 つずつしか数えられませんが、 仮想的な桁を増やしてでも、出現しやすいビットを多く数えられるようにすることで、効率的な圧縮表現になるわけです。
以上が ANS の基本的な考え方になります。
そして、この考え方を使いつつ、元のデータ (さっきの例えでは表と裏の出た順序) を復元できる方法の 1 つが rANS です。 他の方法は Uniform binary variant (uANS) や Tabled variant (tANS) などがあります。
追加するビットが 0 の確率を として、 とします ( は適当に決めてください)。 を掛けているのは自然数にするためで、1 をビット和しているのは割り算で使うからです。 1 の確率は となります。 さらに とします。
このとき符号化中の自然数 に、ビット を追加する符号化関数 は次のようになります。
一方、自然数 を受け取って、1 つ前の自然数 と出力 を得る復号化関数 は次のようになります。
なんとなく で符号化できていて、 がそれを戻しているというのが伝われば OK です。 なお、これを実際に計算すると値がとても大きくなってしまうので、実際には適切な単位で別バッファに出力す必要があります。
コンテキスト・ミキシング
さて、0 と 1 の出る確率さえ分かれば、上記の で符号化して で復号化できることは分かりました。 問題は、どうやって 0 や 1 の出現する確率を知ればいいのでしょうか?
そもそも、圧縮したい文字列全体で見たら 0 と 1 の割合が偏っていることは稀です。 よって、各ビット毎の予測を学習することを考えます。 1 ビット毎に予測していたら各符号化で確率 が変化することになりますが、 符号化を逆順にして、復号する際にも同様の学習を行えば、問題なく復号化が行えます。
というわけで、このようなデータ圧縮でのビット予測に使われる機械学習の手法がコンテキスト・ミキシングです。 これは複数の予測をいい感じに混ぜ合わせて、より適切な予測結果を求めるものになります。
そろそろ記事も長くなってきたし、これは機械学習の記事ではないので、詳しい解説は Wikipedia の記事 に譲りたいと思います。
ともかく、復号時にも同様に学習を行うことで、rANS の復号化を確率のテーブルなどを持たずに行える、ということを覚えておいてください。
実際の解凍コード
これは、さすがに JS Crush よりも複雑になります。 というより複雑すぎてここで説明するのは無理なので、実際の Roadroller のコードを見るのが一番分かりやすいかと思います。 それなりにコメントもあるので、がんばれば読めないこともないでしょう。
ちなみに、圧縮されたコードでは、この解凍部分は 600B ほどあります。 それでも多くの場合で JS Crush よりも小さな結果となるので、rANS とコンテキスト・ミキシングの圧縮効率が優れているのだということが分かります。
あとがき
最後の方はやや駆け足になってしまいましたが、JavaScript の圧縮手法について解説させていただきました。
ここまでの記事では伝え切れなかったのですが、実際にソースコードを短かくするためには、元のソースコードにもいくつか工夫をする必要がある場合もあります。 例えば JS Crush では、重複する部分を小さくしているので、手で極限まで短く書いたコードよりも、あえて重複する部分を作った冗長なコードの方が短くなる、といったことがよくあります。 JS Crush のサイトには関数のシグネチャ (引数名) を揃えるようにするといい、といったアドバイスがありますし、h.js でもバックスラッシュでのエスケープが必要な文字をやや過剰にエスケープすることで、そうしない場合よりも短くなるようにしていたりします。 他にも、置き替える記号が足りなくならないように、元のソースコード上で使う文字の種類を減らすことなども有効だったりします (そうすることで冗長になる部分も多いので一石二鳥です)。 Roadroller はあまり使ったことがないので分かりませんが、同じような注意点があるかもしれません。
なお、h.js で使っている圧縮の実装は JS Crush ではなくて自分で実装したオリジナルのもの (未公開) です。 わりとひどいコードなので公開予定はありません。
この圧縮方法を自分がはじめて知ったのは JS1K に投稿された Mine[love]Craft という作品を見たときでした。 この作品は JS Crush で圧縮されていて、この圧縮方法を自分でも使ってみたい、と思って作ったのが h.js になります。 Mine[love]Craft の作者による解説 も興味深いものなので、是非読んでみてください。
JS Crush より前の JavaScript の圧縮の実装としては jssfx という Python のスクリプトがあるみたいです。 また、このような圧縮方法自体は JavaScript にそこまで依存していないため、他の言語 (例えば Perl) で使われていたテクニックなのではないかと思ったのですが、どうやって調べればいいのか分からなかったので、よく分かっていません。 ここは有識者の意見が求められます。 誰か教えてください。
いつか書こうと思っていた h.js のタネ明かし記事を書けて良かったです。 最後まで目を通していただきありがとうございました。